Jev, développé par TypeSafe AI, défend une idée simple mais structurante pour les équipes produit : toutes les tâches d’intelligence artificielle n’ont pas besoin d’un modèle qui rédige. Lorsqu’un logiciel doit classer un e-mail, sélectionner une route de traitement, attribuer un niveau de risque ou refuser une action sensible, une réponse en texte libre ajoute souvent de la lenteur, du coût et de l’incertitude. Le modèle se positionne donc comme un moteur de décision : il reçoit un contexte, des options cadrées et renvoie un choix exploitable par le code, accompagné d’un niveau de confiance.
Ce virage intéresse directement les entrepreneurs, les éditeurs SaaS et les équipes qui automatisent des opérations à grande échelle. Le sujet n’est pas de remplacer les modèles génératifs dans tous les usages. Il s’agit plutôt de leur enlever les tâches répétitives qu’ils exécutent mal ou trop cher. Dans une architecture moderne, Jev peut devenir le réflexe rapide : celui qui filtre, oriente, contrôle et déclenche, tandis qu’un LLM intervient seulement lorsqu’un raisonnement approfondi ou une réponse rédigée apporte une vraie valeur.
En bref
| Peu de temps ? Voici l’essentiel : |
|---|
| Découpe les workflows : confie le tri et le routage au modèle de décision, la rédaction aux modèles génératifs. |
| Définis des seuils : une prédiction peu confiante doit déclencher un contrôle humain ou un second outil. |
| Teste sur des données réelles : mesure les erreurs métier avant toute automatisation complète. |
| Commence petit : un tri d’e-mails, une qualification de leads ou un filtre de sécurité suffit pour valider le gain. |
IA JEV Classification : comprendre le modèle qui décide au lieu d’écrire
La plupart des personnes ont découvert l’IA à travers un écran de chat. Elles posent une question, le modèle rédige une réponse, puis elles vérifient si le résultat tient la route. Ce réflexe est utile pour écrire une page de vente, résumer un dossier ou produire une première version de script. Il devient beaucoup moins pertinent lorsqu’un logiciel doit simplement trancher entre des actions prévues à l’avance.
Imagine le cas d’une boîte de réception support. Un message entrant doit être envoyé vers « facturation », « problème technique », « demande commerciale » ou « urgence ». Un LLM peut fournir cette information, mais il faudra lui demander un format précis, vérifier qu’il ne raconte pas autre chose, nettoyer éventuellement le JSON retourné et gérer les réponses ambiguës. Jev cherche à supprimer cette couche d’incertitude : son travail n’est pas de composer une phrase convaincante, mais de produire un signal décisionnel structuré.
Classification pure et génération autorégressive : deux logiques opposées
Un modèle génératif avance habituellement token après token. Il prédit un élément de texte, puis le suivant, jusqu’à former une réponse complète. Cette mécanique est puissante, mais elle réclame du calcul et introduit une marge de variabilité. Pour une tâche de rédaction, cette souplesse est une force. Pour décider si une requête doit être bloquée ou autorisée, elle peut devenir un handicap.
Jev fonctionne davantage comme un questionnaire à choix multiple très sophistiqué. L’équipe métier fournit des options fermées et une description claire du contexte. Le système attribue ensuite des probabilités aux possibilités proposées. Cette différence paraît technique, mais elle transforme l’usage concret : le logiciel ne doit plus interpréter un paragraphe produit par l’IA, il peut déclencher directement une règle.
Les primitives mises en avant par TypeSafe AI illustrent cette approche. Choice sélectionne une option parmi un ensemble pouvant aller jusqu’à 255 possibilités. Score place un élément sur une échelle définie, par exemple pour estimer la qualité d’un lead de 2 à 10. Noul couvre la décision binaire : oui ou non, autorisé ou refusé, pertinent ou non pertinent. Ces sorties sont pensées pour s’intégrer dans une logique métier sans analyse fragile de texte libre.
Pour une petite entreprise, cette distinction évite des automatisations décoratives mais peu fiables. Prenons Lila, qui dirige une agence de formation en ligne. Son équipe reçoit des demandes de remboursement, des questions d’accès, des candidatures et des propositions de partenariat. Elle n’a pas besoin d’un système qui écrit une dissertation sur chaque message. Elle veut un aiguillage propre, rapide et mesurable afin que la bonne personne traite la bonne demande.
Le principe du System One Model appliqué aux logiciels
Le terme « System One » fait référence à une décision immédiate, comparable à un réflexe humain. Le cerveau ne mobilise pas la même énergie pour reconnaître un feu rouge et pour préparer une négociation complexe. Les architectures IA gagnent elles aussi à séparer les actions instantanées des raisonnements longs.
Dans ce cadre, Jev ne remplace pas une réflexion approfondie. Il intervient avant : il détecte, classe, hiérarchise et route. Une demande à faible risque est traitée automatiquement. Une demande incertaine part vers un opérateur ou un LLM spécialisé. Cette organisation évite d’envoyer chaque micro-décision vers un outil lourd, coûteux et parfois surdimensionné.
La question à se poser n’est donc pas « quel modèle est le meilleur ? », mais quelle décision doit être prise, avec quelle marge d’erreur acceptable et à quelle vitesse ? C’est une façon plus mature d’aborder l’automatisation. Elle rapproche l’IA des règles métiers réelles au lieu de la cantonner à une interface de conversation.
Cette première brique prépare naturellement le sujet le plus concret pour une entreprise : l’impact sur les délais, les budgets et la fluidité de ses opérations.
Performances de l’IA JEV Classification : vitesse, coût et sorties typées
Les promesses techniques de Jev sont particulièrement séduisantes pour les activités qui traitent de grands volumes. TypeSafe AI communique sur une latence comprise entre 70 et 500 millisecondes selon l’opération et les conditions d’exécution. Là où un modèle génératif peut nécessiter plusieurs secondes pour analyser une requête et produire un texte, un moteur de décision n’a pas à rédiger. Il renvoie donc un résultat plus directement exploitable.
Il faut toutefois garder une lecture opérationnelle des chiffres. Une latence faible ne dépend jamais uniquement du modèle : l’appel réseau, le volume de contexte transmis, les systèmes connectés et les règles internes influencent le délai réellement perçu par l’utilisateur. L’intérêt de Jev se mesure donc dans un workflow complet. Si le tri initial passe de plusieurs secondes à quelques centaines de millisecondes, l’expérience gagne en fluidité, même si une validation humaine intervient ensuite.
Pourquoi l’échantillonnage parallèle change la donne
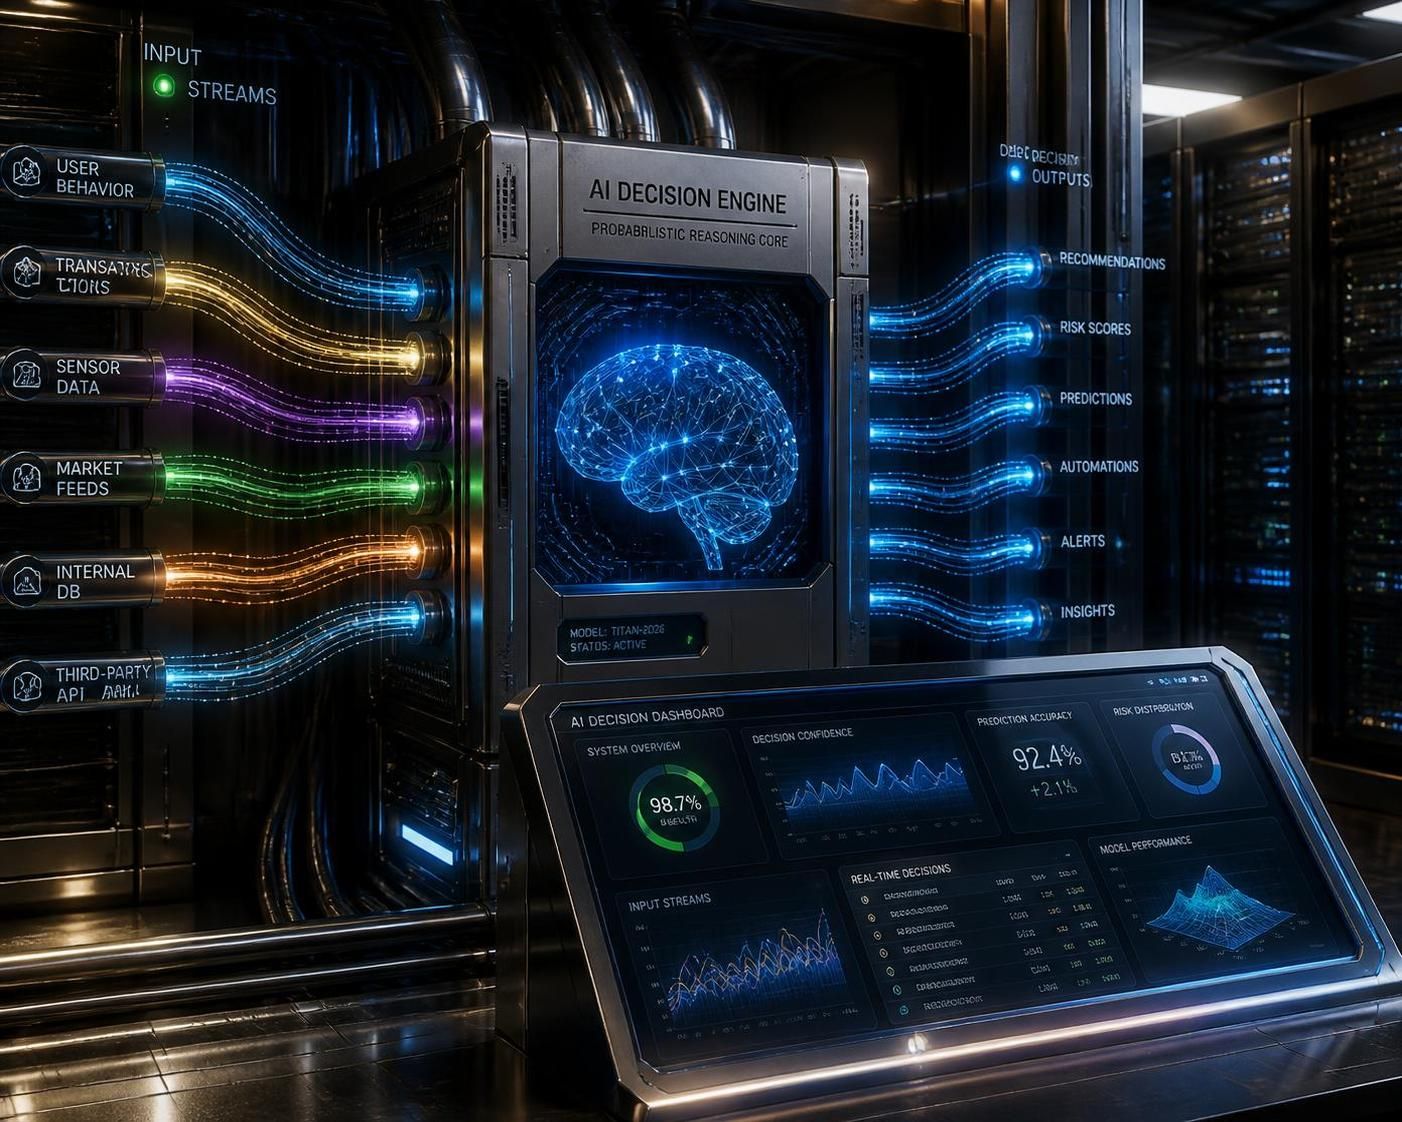
Le cœur de cette efficacité repose sur l’abandon de la génération séquentielle. Au lieu d’attendre la production d’un mot, puis d’un autre, l’architecture évalue les options de décision de manière globale. Elle convertit le contexte sémantique en une distribution de probabilités. Cette logique est mieux adaptée au routage, au scoring et à la validation qu’une réponse narrative.
Le bénéfice ne se limite pas à la vitesse. Lorsqu’une sortie est typée dès le départ, le code sait précisément quoi attendre. Une application n’a pas à gérer une variante du style « Je pense que cette demande devrait probablement aller au support technique ». Elle reçoit, par exemple, « support_technique » avec un score de confiance. Cette stabilité réduit les scripts de nettoyage, les erreurs de parsing et les scénarios imprévus.
Les données fournies évoquent aussi une méthode de calibration appelée RLCD, pour Reinforcement Learning for Calibrated Decisions. L’objectif est de faire correspondre le niveau de confiance exprimé par le modèle à la probabilité réelle d’avoir raison. C’est essentiel. Une IA qui annonce 95 % de certitude tout en se trompant fréquemment est dangereuse. Une IA qui sait signaler son doute devient beaucoup plus facile à gouverner.
| Critère | LLM génératif classique | IA Jev | Impact pour l’activité |
|---|---|---|---|
| Sortie | Texte libre | Choix, score ou décision binaire | Intégration plus directe dans le code |
| Temps de réponse | Souvent de l’ordre de secondes | 70 à 500 ms annoncées | Routage plus fluide à fort volume |
| Format | Variable, à contrôler | Typé par conception | Moins de nettoyage de données |
| Coût annoncé | Variable selon modèle et longueur | 0,042 dollar par million de tokens | Automatisation plus accessible |
Un coût qui mérite une analyse métier plutôt qu’un effet d’annonce
Le prix avancé, soit 0,042 dollar par million de tokens, ouvre une piste sérieuse pour les organisations qui exécutent des classifications en continu. Le bon indicateur n’est pas seulement le coût d’un appel isolé. Il faut calculer le coût par dossier traité, par ticket orienté correctement, par lead qualifié ou par incident évité.
Pour Lila, l’agence de formation, l’enjeu est simple. Si 500 e-mails entrants sont analysés chaque semaine, la dépense d’inférence peut rester marginale face au temps économisé par l’équipe. En revanche, le vrai gain apparaît surtout si le système diminue les transferts inutiles, les réponses tardives et les demandes oubliées. La technologie n’est rentable que lorsqu’elle améliore une métrique métier identifiable.
Certains comparatifs mentionnent un niveau d’accord de 67,8 % face à des modèles très lourds, tout en annonçant un coût nettement inférieur. Ce type de chiffre doit être interprété avec prudence : tout dépend du jeu d’évaluation, des catégories testées et de la qualité des consignes. Le bon réflexe n’est pas de croire un pourcentage isolé, mais de créer ton propre jeu de cas réels avant de basculer un processus sensible.
La performance utile n’est pas celle qui impressionne dans une démo : c’est celle qui enlève une friction mesurable de ton opération quotidienne.
Cas d’usage IA JEV Classification : automatiser le tri sans perdre le contrôle
La valeur d’un modèle de décision apparaît lorsqu’il est connecté à une situation simple, fréquente et coûteuse en attention. Les entrepreneurs confondent parfois automatisation et suppression totale de l’humain. Une meilleure approche consiste à retirer les mini-choix répétitifs qui usent les équipes : ouvrir, lire, reconnaître, transférer, taguer, prioriser. L’humain conserve les décisions à nuance, à impact ou à forte valeur relationnelle.
Routage d’e-mails, tickets et demandes commerciales
Le premier cas d’usage est le plus accessible : catégoriser les messages entrants. Jev peut distinguer une demande de support, une réclamation, une opportunité commerciale, un spam ou une urgence. Chaque étiquette déclenche ensuite une action dans un CRM, une boîte partagée ou un outil de gestion de tickets.
Revenons à Lila. Avant l’automatisation, son assistante parcourt chaque matin les messages, applique des étiquettes et transmet les urgences. Avec un modèle de décision, le système peut taguer les e-mails, détecter les mots ou situations sensibles et envoyer les cas incertains dans une file « à vérifier ». L’assistante ne disparaît pas du processus : elle commence simplement sa journée sur les cas qui demandent réellement son jugement.
Cette logique peut être construite dans un outil d’orchestration. Les nouveautés présentées autour de n8n 2.0 et de ses innovations IA montrent d’ailleurs l’intérêt de relier des modèles spécialisés à des actions métier concrètes. Une classification peut créer une fiche CRM, notifier Slack, ajouter un tag ou déclencher une réponse préparée.
Qualification de leads et priorisation commerciale
Un commercial ne devrait pas consacrer le même effort à toutes les demandes. Pourtant, dans beaucoup de petites structures, les formulaires, messages LinkedIn et demandes de devis s’empilent sans priorisation. Jev peut attribuer un score selon des critères explicites : budget probable, adéquation au service, niveau d’urgence, secteur d’activité ou maturité du besoin.
Il ne s’agit pas de laisser une machine décider qui mérite le respect de l’entreprise. Il s’agit d’organiser l’attention commerciale. Un lead au score élevé peut recevoir une proposition de créneau rapidement. Un lead peu mûr peut entrer dans une séquence de contenu. Une demande hors cible peut être réorientée avec courtoisie. Cette segmentation permet de répondre mieux, pas seulement plus vite.
Pour rendre ce tri fiable, les critères doivent être écrits noir sur blanc. « Lead intéressant » est trop vague. « Entreprise de 10 à 100 salariés, besoin exprimé, échéance sous 90 jours, budget évoqué ou demande de démonstration » est une base bien plus utilisable. Le modèle ne compense pas un processus commercial flou ; il le révèle.
Sécurité, fraude et réputation client
Les décisions binaires sont aussi adaptées à la prévention. Détecter un SMS de phishing, identifier une pièce jointe potentiellement dangereuse, repérer un avis client très négatif ou signaler une consigne qui tente de contourner un agent : ce sont des décisions rapides qui bénéficient d’un score de confiance.
Dans un e-commerce, un avis classé « mécontentement critique » peut ouvrir automatiquement une tâche pour le responsable relation client. Dans une équipe RH, une offre d’emploi reçue par e-mail peut être évaluée selon des règles de sécurité simples avant d’être transférée. Dans une application interne, chaque commande émise par un agent IA peut être contrôlée par une couche qui vérifie si l’action respecte les règles définies.
La gestion de ces flux devient encore plus solide lorsqu’elle est adossée à une véritable stratégie de gestion des données. Des catégories mal définies, des historiques incomplets ou des exemples biaisés produiront des décisions discutables, même avec un moteur très rapide.
Un bon cas d’usage commence là où le volume est élevé, la décision cadrée et l’erreur facilement observable.
Architecture agentique avec Jev : combiner vitesse, raisonnement et garde-fous
Le piège consiste à vouloir placer un seul modèle au centre de tout. Dans la pratique, une architecture robuste ressemble davantage à une équipe bien organisée : un premier niveau filtre, un spécialiste traite les cas complexes et une personne valide les décisions à risque. Jev peut occuper ce premier niveau, car il est conçu pour prendre des micro-décisions structurées sans produire de prose inutile.
Mettre Jev en première ligne du routage
Une architecture simple peut suivre cette séquence : la demande arrive, Jev la catégorise, puis le système choisit le chemin adapté. Un message banal reçoit une réponse issue d’une base de connaissances. Une demande délicate part vers un LLM avec davantage de contexte. Une anomalie passe à un humain. Ce design limite les appels coûteux et réduit l’encombrement des files de traitement.
Pour une agence, cela peut concerner les prospects. Pour une plateforme SaaS, il peut s’agir de tickets techniques. Pour un créateur de contenu, l’outil peut trier les partenariats, les messages de communauté et les demandes de presse. Le principe reste identique : ne mobilise le raisonnement lourd que lorsque la situation le justifie.
Les agents deviennent alors plus prévisibles. Une demande utilisateur ne se transforme pas automatiquement en action. Elle est d’abord évaluée : est-elle autorisée ? pertinente ? urgente ? nécessite-t-elle des données sensibles ? Jev peut fournir ce verrou initial avant tout appel à un agent plus autonome.
Construire une règle d’escalade claire
Le score de confiance ne doit jamais rester un simple chiffre décoratif dans un tableau de bord. Il doit déclencher une règle. Une approche pragmatique consiste à utiliser un seuil de 75 %. Au-dessus, l’action peut être automatisée si son impact reste modéré. En dessous, le système sollicite un contrôle humain, demande une précision ou bascule vers un modèle de raisonnement.
Cette règle doit varier selon les conséquences. Pour attribuer une étiquette à un e-mail, un seuil modéré peut suffire. Pour bloquer un compte, envoyer un document contractuel ou supprimer une donnée, l’exigence doit être beaucoup plus élevée. L’automatisation responsable ne cherche pas à faire disparaître le doute : elle organise la réponse au doute.
Voici un cadre simple à appliquer avant un déploiement :
Des agents plus sûrs grâce à une couche de contrôle
Un agent IA connecté à des outils peut rechercher une donnée, mettre à jour une fiche, envoyer un message ou créer un document. Cette capacité devient intéressante seulement si elle reste contrôlée. Jev peut servir de garde-fou en évaluant les appels envisagés par l’agent : l’action est-elle compatible avec la demande initiale ? contient-elle une information confidentielle ? faut-il obtenir une approbation ?
Cette complémentarité est particulièrement utile pour les entreprises qui expérimentent des agents autonomes. Les méthodes détaillées autour d’OpenClaw et des agents IA rappellent qu’un agent performant n’est pas celui qui agit sans limite, mais celui qui sait quand agir, quand vérifier et quand s’arrêter.
Pour Lila, le résultat se traduit très concrètement : son agent peut préparer une réponse client, mais Jev vérifie si la demande comporte une réclamation, une annulation ou une donnée sensible. Dans ce cas, le message n’est pas envoyé automatiquement. Il part dans une file de validation. Cette petite couche protège la réputation de l’entreprise sans ralentir toutes les interactions.
Une architecture intelligente ne cherche pas à automatiser chaque geste ; elle automatise les gestes qui peuvent être contrôlés.
Déployer IA JEV Classification : méthode de test, limites et pilotage durable
Le déploiement d’un modèle de décision ne demande pas forcément une infrastructure massive dès le premier jour. Des accès via API, notamment depuis les plateformes TypeSafe ou OpenRouter, permettent de construire un prototype. Mais la simplicité technique ne doit pas pousser à brûler les étapes. Le vrai travail se situe dans la définition des catégories, la qualité des exemples et le suivi des erreurs.
Commencer par une classification binaire
Le moyen le plus propre de tester Jev est de commencer par une décision oui/non. Par exemple : « Cette demande doit-elle être transmise au support humain ? » ou « Ce message contient-il une tentative de phishing ? ». Les catégories binaires exposent vite les ambiguïtés de la formulation et facilitent l’analyse des résultats.
Une consigne efficace décrit le contexte, les critères et les sorties attendues. Elle évite les formulations floues. À la place de « Ce prospect est-il bon ? », préfère : « Au regard du message, ce prospect demande-t-il explicitement une démonstration et correspond-il à l’un des secteurs ciblés ? ». La précision du langage métier détermine largement la précision de la décision.
Le code peut ensuite gérer le résultat avec une règle simple. Si le modèle répond oui avec un score supérieur au seuil choisi, l’action est lancée. Sinon, la demande est classée dans une file à examiner. Cette logique paraît basique, et c’est précisément son avantage : elle est compréhensible par l’équipe, vérifiable par les développeurs et améliorable par les responsables métier.
Respecter les limites réelles du modèle
Jev n’est pas un outil de rédaction. Il ne résume pas un rapport, ne rédige pas une séquence e-mail et ne mène pas un raisonnement long à plusieurs étapes. Il n’est pas non plus le choix idéal pour des calculs complexes, des comparaisons de dates très nuancées ou des problèmes reposant sur de multiples niveaux d’indirection.
Cette limite n’est pas un défaut caché : elle définit son positionnement. Demander à Jev de rédiger une page de vente serait aussi absurde que demander à un logiciel de comptabilité de concevoir une identité visuelle. Les meilleurs systèmes sont spécialisés. Une fois cette idée intégrée, l’architecture devient plus simple à piloter et moins coûteuse à faire évoluer.
Les décisions impliquant une donnée personnelle, un enjeu juridique, une suspension de compte ou une transaction financière doivent être soumises à une politique d’escalade stricte. La vitesse ne justifie jamais une décision irréversible prise sans contrôle. Il faut conserver les journaux d’événements, tracer les motifs de routage et permettre une correction rapide.
Mesurer la qualité dans la durée
La mise en production n’est pas la fin du projet. Les expressions utilisées par les clients changent, les offres évoluent et de nouvelles catégories émergent. Une classification qui fonctionne parfaitement en avril peut perdre en qualité quelques mois plus tard si les données entrantes ont changé. C’est le phénomène de dérive.
Prévois un tableau de bord simple : taux d’accord avec les validations humaines, nombre de cas escaladés, temps moyen de traitement, coût par flux et catégories les plus ambiguës. Chaque semaine, Lila peut échantillonner quelques décisions automatiques et les comparer à ce qu’aurait fait son équipe. Cette routine de vingt minutes évite que l’automatisation devienne une boîte noire.
Le choix entre API et auto-hébergement relève aussi d’une décision stratégique. L’API permet de tester vite et de limiter la charge technique. L’auto-hébergement apporte davantage de maîtrise sur les données et l’infrastructure, mais exige des compétences, une supervision et un budget d’exploitation. Pour une TPE ou une PME, il est pertinent de comprendre les besoins propres à la définition et aux réalités des TPE-PME avant de transformer une expérimentation en projet lourd.
Le déploiement gagnant est celui qui reste lisible : une décision définie, un seuil documenté, un responsable identifié et une amélioration continue.
Jev peut-il remplacer un LLM comme ChatGPT ou Claude ?
Non. Jev est conçu pour choisir, noter ou valider dans un cadre fermé. Un LLM reste plus adapté à la rédaction, au résumé, à la recherche d’explications et au raisonnement complexe. Les deux outils deviennent plus efficaces lorsqu’ils sont utilisés ensemble.
Quel premier cas d’usage choisir pour tester Jev ?
Commence par un flux répétitif, à faible risque et facile à vérifier : tri d’e-mails, orientation de tickets, détection de spam, qualification de leads ou analyse de sentiment d’avis clients. Évite d’emblée les décisions financières ou juridiques sensibles.
Comment utiliser le score de confiance dans une automatisation ?
Transforme-le en règle métier. Par exemple, une décision supérieure à 75 % peut être exécutée automatiquement pour une action simple ; en dessous, le système doit demander une validation humaine, collecter davantage de contexte ou appeler un modèle de raisonnement.
Pourquoi les sorties typées sont-elles importantes ?
Elles réduisent les erreurs d’intégration. Au lieu de devoir interpréter un texte libre ou corriger un JSON imprévisible, l’application reçoit un choix, un score ou un oui/non directement compatible avec ses règles de traitement.